 技術專欄
文/MetaAge 邁達特技術顧問 Harry Wang
隨著生成式 AI 與 LLM 的快速發展,AI 推論所需要處理的資訊量也持續增加。除了模型本身的大小之外,如何保存模型在推論過程中已經處理過的上下文,也逐漸成為 AI 基礎架構需要面對的重要課題。
作為 MinIO 台灣官方代理商,MetaAge 邁達特觀察到,現代 AI 推論已從單純的「算力競賽」,轉向「記憶體架構與資料流管理」的效率決策。本文將深入剖析 LLM 核心的 KV Cache 瓶頸,並介紹儲存巨頭 MinIO 所推出的革新解法:MemKV。
針對上述挑戰,MinIO 於 2026 年 5 月正式推出 MemKV,這是一套專為 AI 推論設計的 Context Memory 儲存。MemKV 的主要目的,是將 GPU 無法長時間保存的 KV Cache,存放至高效能的共享記憶體層,讓不同的推論節點都能存取這些已經計算過的上下文,減少因為 KV Cache 被淘汰而必須重新計算的情況。
不過,在了解 MemKV 之前,讀者必須先理解一個關鍵問題,那就是為什麼 AI 推論需要保存這些上下文?而這些資料又為什麼會逐漸成為 GPU 記憶體的負擔?
要理解 KV Cache,可以先想像使用者平常與 ChatGPT 這類 AI 進行對話的這類情境。當使用者輸入一個問題後,AI並不是直接從資料庫中找到一個完整答案,而是由大語言模型根據上下文,一個 Token 一個 Token 地產生回答。模型在產生回答時,需要理解前面已經出現的文字,才能知道目前正在討論什麼,因此模型在處理每一個新的 Token 時,都需要參考前面 Token 提供的資訊。
這時就出現了一個問題,如果每產生一個新的 Token,都要把前面所有內容重新計算一次,效率會非常低。為了避免大量的重複計算,大語言模型在推論過程中會將已經計算過的部分資訊暫存在 GPU 的記憶體中,這就是 KV Cache。
KV Cache 就像是 AI 在推論過程中建立的筆記,模型不需要每次都重新閱讀前面的所有內容,而是可以直接使用已經整理好的筆記,繼續處理後面的 Token。這個機制對 LLM 非常重要,尤其當 AI 開始處理越來越長的上下文,例如長篇文件、程式碼、大量對話紀錄或 Agent 工作流程時,KV Cache 的重要性也會跟著提高。
KV Cache 有一個重要特性,就是它會隨著您的 Context 長度增加而跟著增加,當 AI 只需要處理幾千個 Token 時需要保存的 KV Cache 資訊並不多,但如果 Context 上升到幾萬甚至是幾十萬 Token,模型就需要保存更多的資訊。而除了上下文長度外,同一時間的使用者數量也會影響 KV Cache 的需求。以 MinIO 官方提供的 llama 3.1 70B BF16 範例來看,當 Context 達到 64K Token 時,單一 Session所需要的 KV Cache 約為 20 GiB,如果同時存在 128 個這類 Session,整體 KV Cache 需求就可能達到約 2.5 TiB。
這就帶出了一個問題,GPU HBM 記憶體沒辦法存放這麼多的 KV Cache。當 KV Cache 的需求超過 HBM 可以提供的容量時,系統就必須想辦法處理多出來的資料。其中一種方式,就是將部分 KV Cache Evict (淘汰)或 Offload (卸載)。假設使用者正在與 AI 進行一段很長的對話,GPU 已經為這段對話建立了 KV Cache,當新的 AI 請求不斷進來,GPU HBM 空間逐漸被占滿,系統可能需要把較早建立的 KV Cache 移除,為新來的 KV Cache 騰出空間。但是這些被淘汰的 KV Cache 並不是從此不再需要了,如果使用者又回到原本的對話,AI 還是需要理解前面的 Context,因為舊的 KV Cache 已被淘汰, GPU 就得浪費運算資源,重新跑一次運算把 KV Cache 再建回來,這也是所謂的 「重算稅」(Recompute Tax)。
因此當 AI 應用開始使用長 Context、高併發、多輪對話,問題就不再只是 GPU 算力不夠,變成了如何有效保存和管理大量的 KV Cache,避免 GPU 不斷重複計算 Context。
MinIO 推出的新產品 MemKV,就是為了解決大量 KV Cache 儲存而生的外部記憶體共享層。MemKV 並不是要取代 GPU HBM,而是補足了 GPU HBM 在容量與共享性上的限制。
其核心概念很簡單,就是把 KV Cache 像是資料在做冷熱分層一樣,依照使用頻率放在不同的地方,目前正在使用、需要快速存取的 KV Cache 就放在速度快但容量小的 GPU HBM。當 HBM 空間不足時,存取頻率較低、無非常高效需求、較舊的 KV Cache,就 Offload 到速度較慢、但是容量大很多的 MemKV 外部記憶體共享層。如此一來,就能保存大量的 KV Cache,讓多個不同的推論工作負載,可以在這裡重新取得先前已經計算過的 Context,避免掉一些不必要的重複計算,並且讓 KV Cache 從原本的單一 GPU本地資源,變成可以跨 GPU 跨推論節點使用的共享資源。
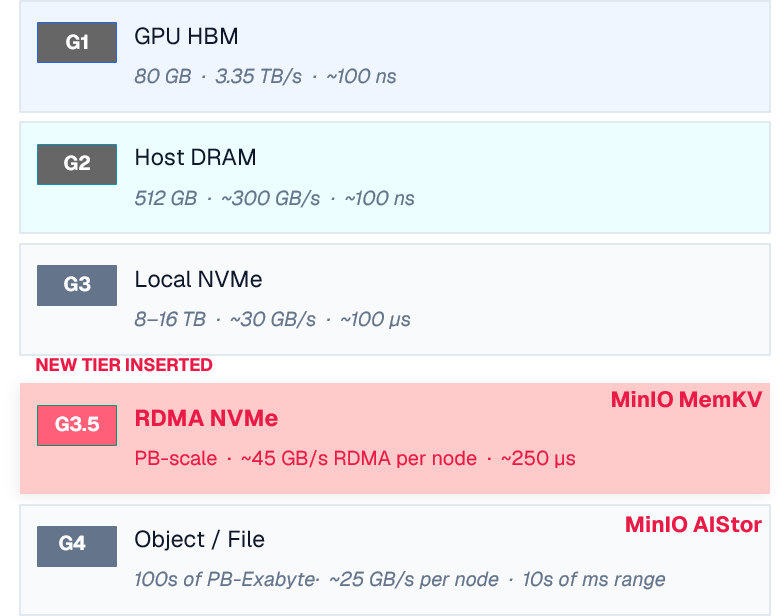
圖 1/MemKV 示意圖
在 MinIO 的設計中,MemKV 的實際架構用單台或是多台的 X86 Server 插需求容量的 NVMe 硬碟組成的儲存,且前端的 GPU Server 和 MemKV Server 都使用支援 RDMA 的網卡,並建立 RDMA Fabric,就可以利用 RDMA 和 NVMe 建立高速資料傳輸路徑,讓 KV Cache 可以在 GPU 與 MemKV 之間以最快的方式進行存取。
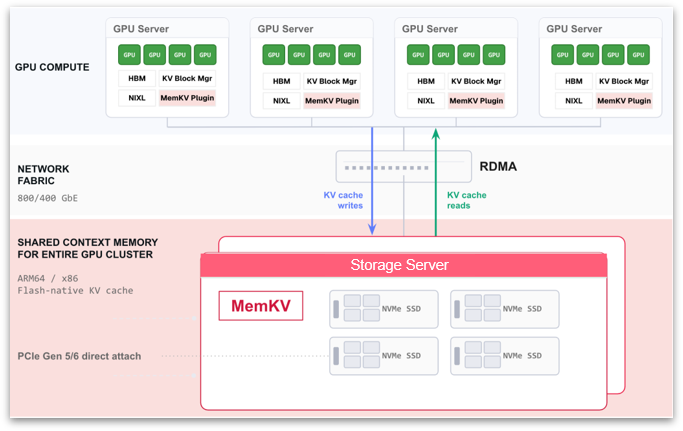
圖 2/KV Cache在GPU與MemKV之間可以最快方式存取
在了解完架構後,下一步看 MinIO 官方針對 MemKV 進行的效能測試。測試使用 8 張 NVIDIA H100、Llama 3.3 70B 模型、vLLM 推論引擎與 MemKV,在不同 Context Length 下比較「重新計算 KV Cache」與「使用 MemKV 取回 KV Cache」的 Time to First Token(TTFT)。在 24K Token Context、28 個併發請求的條件下,Baseline 的 P99 TTFT 為 60.8 秒,使用 MemKV 後則降低至 2.96 秒,約為 20.5 倍的改善。而且從測試結果也可以看到,Context 越長,兩者之間的差距越明顯。
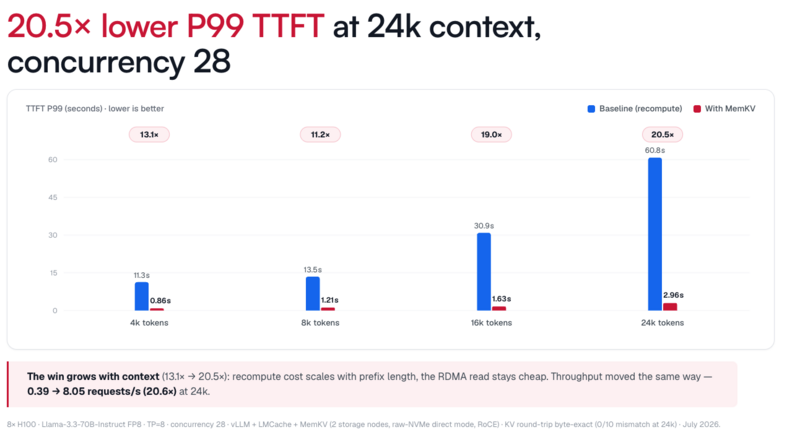
圖 3/MemKV實際效能表現
該項結果背後的原因,正好呼應前面所介紹的 KV Cache 問題:Context 越長,重新運算所需要付出的計算成本也越高;而 MemKV 可直接取回已經建立的 KV Cache,避免再次進行完整的 Context 計算。
前文談到許多 MemKV 改善或解決 KV Cache 的問題,但是這並不代表所有 AI 推論工作負載都一定需要 MemKV。當 KV Cache 本身就能完全放進 GPU HBM,或者工作負載幾乎沒有 Context 重複使用時,將 KV Cache 放到額外的 Memory Tier 所能帶來的效益就會相對有限。
真正適合 MemKV 的情境是 KV Cache 的量開始超過 GPU HBM 的容量,同時又存在大量 Context 重複使用的 AI 推論環境。此時將 KV Cache 從 GPU 本地資源提升為共享的資源,才有機會降低不必要的重新計算。
存在長 Context(長文件分析、代碼庫理解)、高併發、多輪對話,且大量重複使用 Context 的企業級 AI 推論環境。
Context 極短(僅幾百 Token)或每次請求完全獨立且無重複性的任務,直接存放在 GPU HBM 即可。
延伸閱讀:
過去談到 AI 基礎架構時,人們往往首先想到的是 GPU 數量、GPU 算力,以及 GPU 之間的高速互連。然而,隨著大型語言模型的 Context 越來越長,以及 AI Agent、長文件分析、多輪對話等應用逐漸普及,如何保存與管理模型已經處理過的 Context,也開始成為推論架構的重要課題。
MinIO MemKV 的出現,讓以往遇到 KV Cache 沒地方存、淘汰機制導致 GPU 反覆做一樣的計算、KV Cache 只存在單一 GPU 作為本地資源等問題,逐一得到解決。對於未來的 AI 推論環境而言,GPU 的算力仍然重要,但如何有效管理 GPU 之外的 Context Memory,同樣可能成為打造高效率 AI 基礎架構不可忽略的一環。
作為 MinIO 在台灣的官方授權合作夥伴,MetaAge 邁達特認爲 MemKV 的問世,標誌著 AI 基礎架構邁入全新的里程碑。過去企業在規劃 AI 軟硬體時,多半採用「不夠就加 GPU」的暴力擴充模式。然而,在成本與電力受限的現實下,「記憶體分層」(Memory Tiering) 將成為企業降低總擁有成本的關鍵密碼。
當 AI 應用進入深水區,決定勝負的不僅是模型有多聰明,還有基礎架構能否提供流暢、低延遲、可擴充的體驗。MinIO MemKV 成功打破了 HBM 的容量牆,讓 KV Cache 從單點瓶頸轉化為共享優勢。邁達特則具備豐富的系統整合與 AI 基礎架構規劃經驗,能協助企業精準評估 AI 工作負載,避免盲點與資源浪費,讓每一分 GPU 預算都花在刀口上。
想了解您的 AI 推論架構是否面臨「重算稅」問題?或希望部署最先進的 MinIO MemKV 解決方案?【立即由此聯繫 MetaAge 邁達特專業顧問團隊】,讓 MetaAge 邁達特為您提供完整的 MinIO 軟體授權、架構諮詢與 POC 實測支援,助您解鎖企業 AI 推論的最大潛能。
A1:不會。 MemKV 的定位是「外部共享記憶體層」,屬於記憶體分層架構的一環。正在進行極速矩陣運算的 KV Cache 依然會在 GPU HBM 中處理;MemKV 是接收從 HBM 溢出或卸載的資料,以防資料被丟棄後需要耗費 GPU 算力重新計算。
A2:MetaAge 邁達特是 MinIO 在台灣的授權合作夥伴,擁有經驗豐富的架構師團隊,不僅可提供原廠授權與技術支援,還能結合企業現有的 NVIDIA GPU 伺服器、高速網路(RDMA/InfiniBand)及儲存設備,提供一站式的 AI 基礎架構規劃與落地服務。
A3:MemKV 主要與主流的 AI 推論框架(如 vLLM 等)進行整合。透過架構層面的優化,企業可以在不大幅改動上層業務邏輯的前提下,大幅降低 Time to First Token (TTFT) 並提升整體吞吐量。MetaAge 邁達特團隊則可協助評估您的系統環境並提供最佳導入建議。

